程式語言與文字分析
- Python
- spaCy
以 Python 生態系整理文字處理流程,spaCy 提供自然語言分析工具。將法規內容準備為可進行比對的資料,銜接後續版本差異處理。
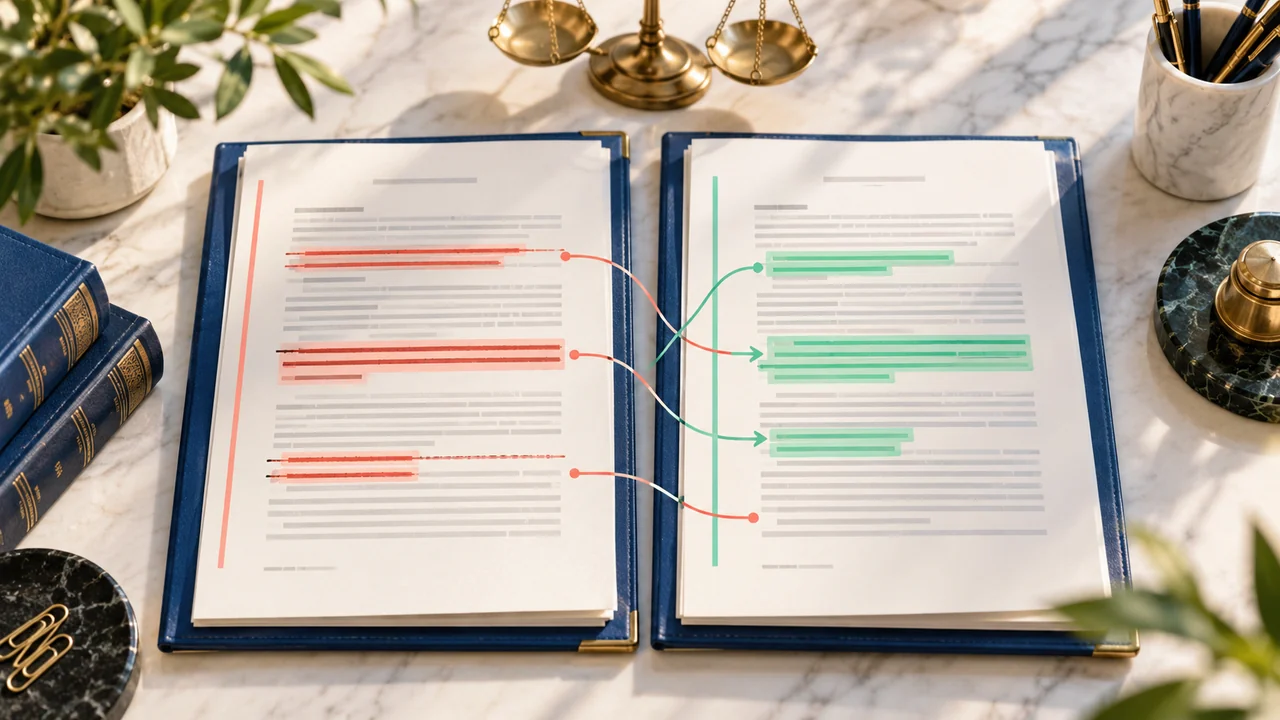
技術應用情境示意
法規改版需要逐項追蹤新舊文字差異,並整理為方便人工檢視的資訊。
形成法規資料處理與版本比較工具,支援變更追蹤與人工檢視。
將新舊法規文字整理為可比較的資料,結合文字分析及差異演算法,產出變更標記與法規對照資訊。
以 Python 生態系整理文字處理流程,spaCy 提供自然語言分析工具。將法規內容準備為可進行比對的資料,銜接後續版本差異處理。
以 Diff-Match-Patch 進行新舊文字的差異處理,取得新增、刪除及相異內容。將演算法結果整理為變更標記,協助使用者辨識法規版本之間的文字變化。
以 Pandas 整理法條與差異相關資料,銜接對照資訊的產出。將文字處理結果轉為結構化的表格資料,方便人工檢視新舊版本。
整合文字分析、差異比對與資料整理,支援法規改版的變更追蹤。工具提供文字差異及對照資訊,讓人工檢視可以集中在實際變更的內容。
將兩個版本的文字準備為比對資料。
透過差異演算法取得文字變更內容。
將差異及條文資料整理為可檢視的表格。
案例依產業與技術成果呈現,客戶與專案識別資訊已去識別化。